판다스 시리즈 완전 정복 — 인덱스·결측치·불리언 인덱싱 3가지 핵심 개념
판다스 시리즈(Series) 생성부터 인덱스 구조·결측치 처리·불리언 인덱싱까지 — 데이터프레임으로 넘어가기 전에 반드시 잡아야 할 3가지 핵심 개념을 엔지니어 언어로 정리한다.
판다스 시리즈(Series) 생성부터 인덱스 구조·결측치 처리·불리언 인덱싱까지 — 데이터프레임으로 넘어가기 전에 반드시 잡아야 할 3가지 핵심 개념을 엔지니어 언어로 정리한다.
프론트엔드 프레임워크는 Django로 데이터를 처리한 다음 단계인 화면 구성 역할을 한다. Bootstrap이 CSS 클래스만으로 UI를 완성하는 방식, Django와의 역할 구분, AI 프롬프트 적용법까지 한 번에 정리했다.
numpy 배열의 생성부터 reshape, random, 인덱싱, Fancy Indexing까지 5가지 핵심 개념을 한 글에 정리했다. 배열 구조를 모르면 AI에게 코드를 받아도 수정 요청조차 어렵다. 실전 조작법을 익혀두면 데이터 전처리 속도가 달라진다.
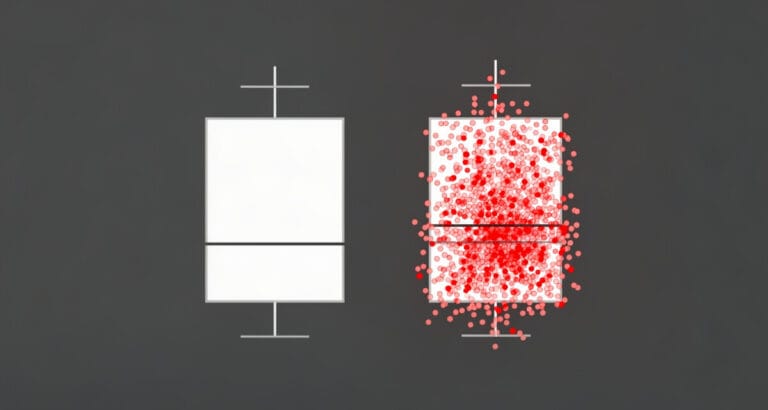
파이썬 시각화는 코드보다 흐름이 먼저다. pandas 내장 차트와 seaborn의 개념적 차이, boxplot+swarmplot 조합의 이유, AI에게 시각화를 맡길 때 개념이 왜 필요한지를 현장 엔지니어 시각으로 정리했다.
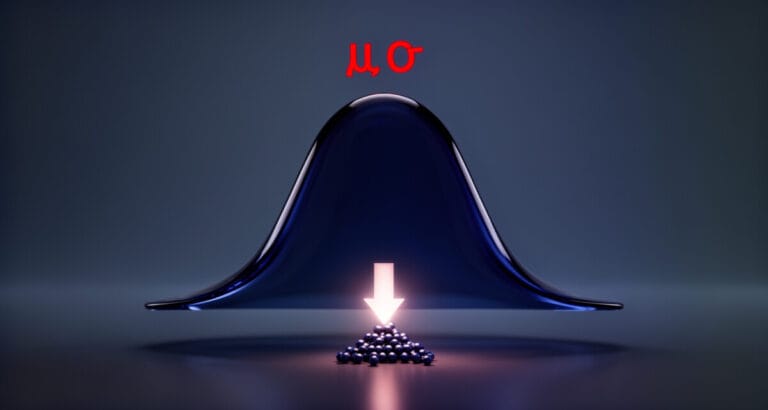
모수는 존재하지만 알 수 없다 — 그래서 통계학이 있다. 모수 뜻 한 줄 정의에서 멈추지 않고, 모집단을 어떻게 정의하느냐에 따라 분포가 달라지는 실무 포인트, 이상치가 있을 때 평균·중앙값 선택 기준, 4가지 모수 분류표까지 제조 현장 예시로 정리했다.
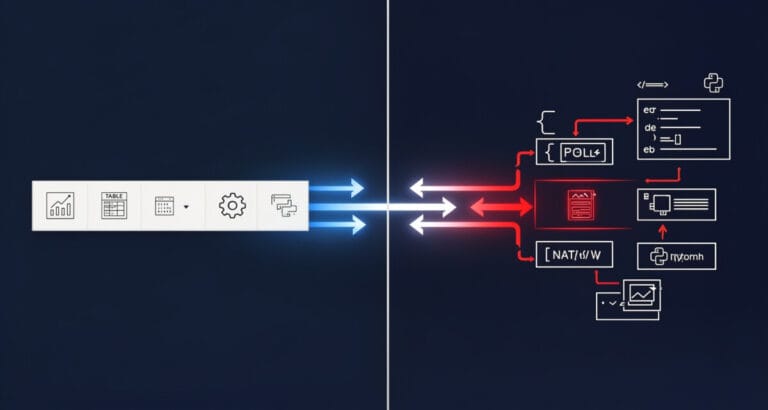
파이썬 라이브러리는 엑셀 툴바 아이콘 묶음과 같다. pip install→import→사용 3단계 구조와 내장 함수와의 차이를 이해하면, AI에게 받은 코드가 왜 실행되지 않는지, 어떻게 수정 요청을 해야 하는지 스스로 판단할 수 있게 된다.
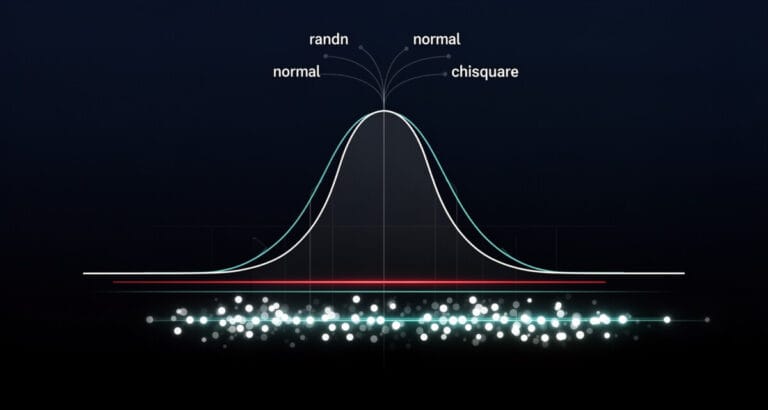
numpy 난수 생성 함수 randn·normal·chisquare·seed의 차이와 판단 기준을 정리했다. AI에게 정확하게 요청하기 위한 개념 이해와 프롬프트 예시까지 한 번에 확인할 수 있다.
pandas 전처리의 핵심 5단계를 한 번에 정리했다. CSV·엑셀 파일 입출력부터 결측값 처리, loc·iloc 인덱싱, 조건 필터링, 행·열 삭제까지 — 데이터 분석 전에 반드시 잡아야 할 pandas 전처리 흐름을 실전 코드와 함께 설명한다.
판다스 결측치인 NaN·None·NA가 섞인 채 분석하면 결과가 틀리거나 에러가 난다. 각각의 차이, dropna·fillna 사용법, loc·iloc까지 이해하면 AI에게 정확한 데이터 처리를 요청할 수 있게 된다.
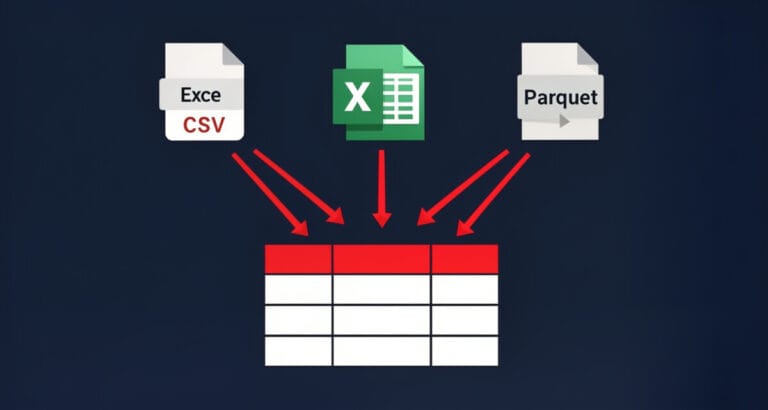
판다스 dataframe으로 CSV·Excel·Parquet 파일을 불러오는 방법과 인코딩 오류 해결법, float64·float32 타입 변환까지 3단계로 정리했다. 파이썬 데이터 분석 첫 단계를 완전히 잡고 싶은 엔지니어라면 이 글부터 시작하자.