AI 에이전트를 조직에 깔기 전에 — 개인 AI와 우리의 AI를 가르는 3가지
AI 에이전트를 조직에 들이기 전에 반드시 짚어야 할 기준이 있다. 개인 AI와 조직의 AI가 어떻게 다른지, 일을 먼저 정의해야 하는 이유, 사람당 에이전트 1개 해법이 뜻하는 바까지 현장 엔지니어 관점에서 정리했다. 조직 개편부터 시작하면 반드시 실패한다.
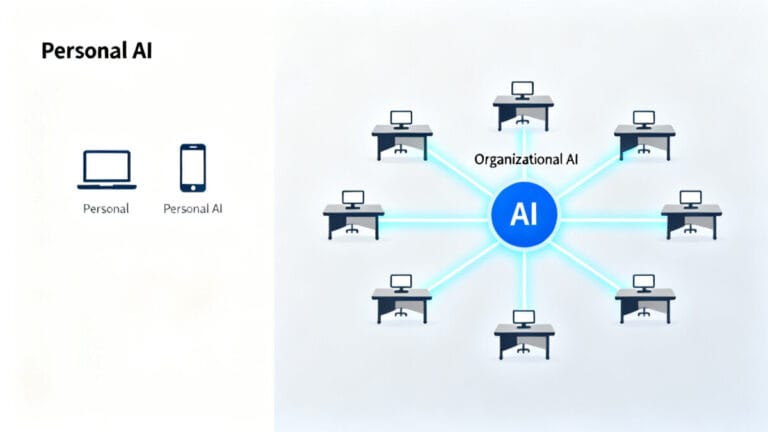
AI 에이전트를 조직에 들이기 전에 반드시 짚어야 할 기준이 있다. 개인 AI와 조직의 AI가 어떻게 다른지, 일을 먼저 정의해야 하는 이유, 사람당 에이전트 1개 해법이 뜻하는 바까지 현장 엔지니어 관점에서 정리했다. 조직 개편부터 시작하면 반드시 실패한다.
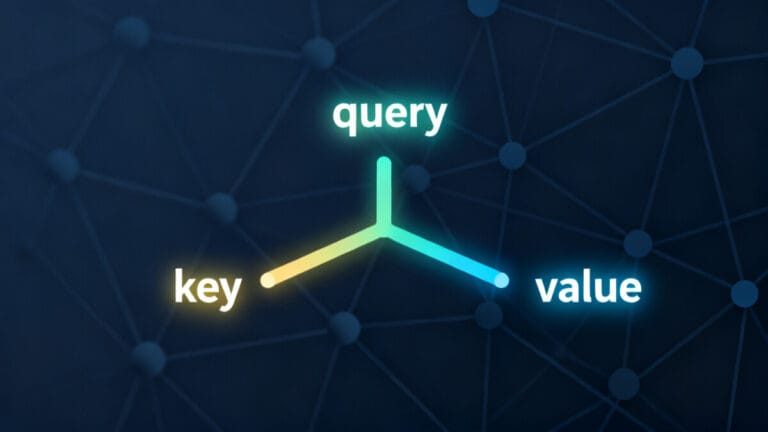
QKV는 쿼리·키·밸류의 줄임말로, 어텐션이 문맥을 만드는 핵심 장치다. 정답을 찍는 일반 DB와 달리 QKV가 맥락을 만드는 원리와 멀티헤드 어텐션 구조까지 3단계로 정리했다.
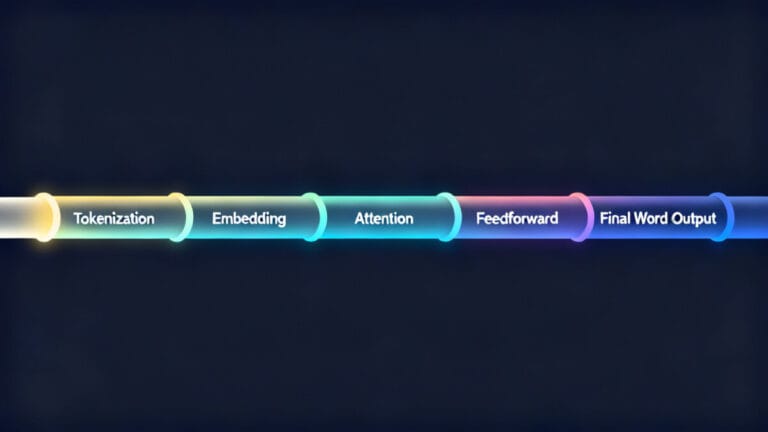
LLM 동작 원리는 토큰화·임베딩부터 어텐션, FFN, 소프트맥스·디코딩까지 이어지는 5단계 파이프라인이다. 트랜스포머 블록 내부와 학습·추론의 차이까지 한 번에 정리했다.
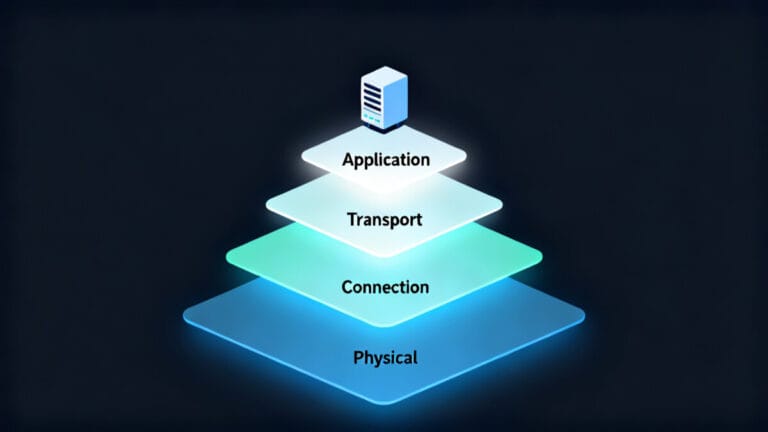
네트워크 계층은 물리 연결·주소·전송 방식·응용 프로토콜 4단계로 이루어진다. TCP·IP·HTTP의 역할과 FastAPI가 이 설정을 한 줄로 끝내는 이유까지 정리했다.
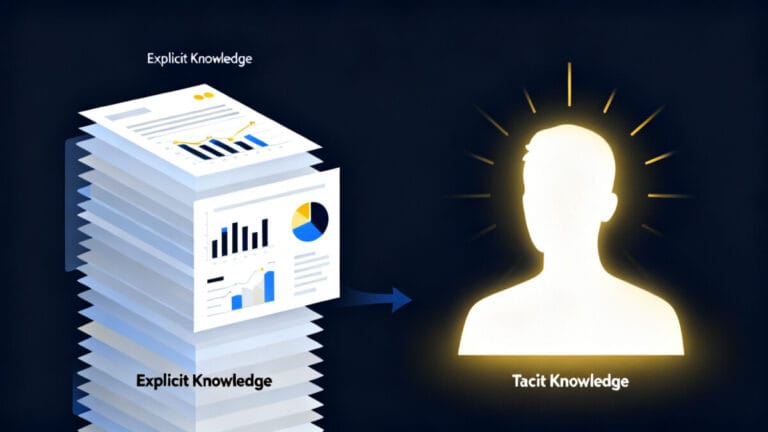
워런 버핏의 135억짜리 점심이 증명한 도메인 지식의 값. 명시적 지식과 암묵지가 어떻게 다른지, AI가 왜 현장 전문가의 판단을 대체하지 못하는지 3가지 구조로 정리했다. 엔지니어의 경험이 AI 시대에 무기가 되는 이유를 확인해보자.
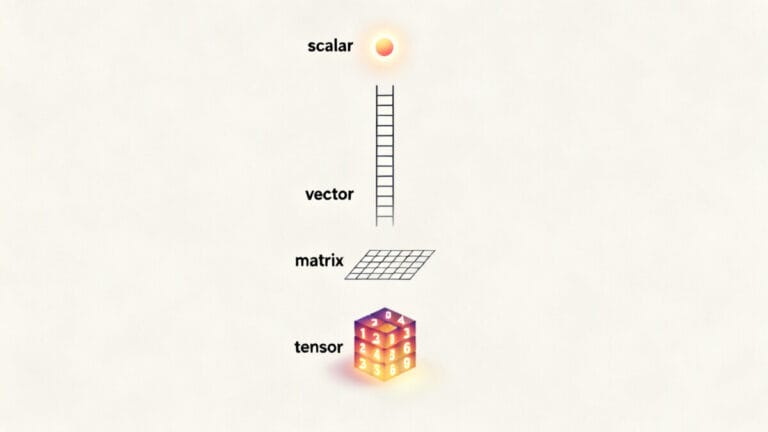
AI 수학 언어의 핵심은 벡터·행렬·텐서와 벡터의 내적이다. AI가 데이터를 숫자로 처리하는 원리부터 GPU가 텐서 계산기인 이유, 내적이 곧 유사도인 이유까지 3단계로 정리했다.
핸드오프 파일과 compact는 요약을 넘긴다는 원리만 같고 작동이 전혀 다르다. 문서 13건으로 Claude Code 세션을 8주간 이어붙인 실측으로 재개 비용과 통제권 차이, 문서에 담을 4절 양식, 자동 안전망을 병행하는 기준까지 한 글에 정리했다.

분류 성능지표는 혼동행렬의 네 칸(TP·FP·FN·TN)에서 출발합니다. 정확도가 클래스 불균형에서 왜 속이는지, 재현율과 정밀도의 차이, F1과 G-mean 종합지표, 임계값 조정까지 정리했습니다.
로지스틱 회귀는 어느 쪽인지(분류)를 확률로 예측하는 방법입니다. 직선으로는 왜 확률을 못 맞히는지, 오즈와 로짓으로 범위를 맞춰 S자 곡선을 만드는 과정, 계수를 최대우도법으로 구하는 이유까지 정리했습니다.
계수 축소법(Ridge·Lasso)은 회귀식에 벌점을 더해 불필요한 변수를 자동으로 걸러내고 과적합을 막는 방법입니다. Ridge와 Lasso의 차이, 예측이냐 변수 선택이냐에 따른 선택 기준, λ 튜닝까지 정리했습니다.