Skip to content
deepcarpenter logo 파일

deepcarpenter | Build Deep, Think Deeper

  • 홈
  • AI · AXExpand
    • 실전 · 워크플로우
    • 인사이트 · 전환
  • DomainExpand
    • 현장 엔지니어링
    • 엔지니어 마인드셋
  • seriesExpand
    • 파이썬 데이터분석
    • 통계·데이터
    • 웹·백엔드(Django)
  • 블로그
  • 문의하기
  • About
deepcarpenter logo 파일
deepcarpenter | Build Deep, Think Deeper
  • 3차원 공간의 점들에 하나의 평면을 맞춘 다중선형회귀 초평면 도식

    다중선형회귀란 무엇인가 — 변수 2개면 평면, 3개면 초평면

    2026년 08월 28일 통계·데이터

    다중선형회귀는 입력 변수 여러 개로 결과를 예측하는 회귀입니다. 변수가 늘면 직선이 초평면이 되는 이유, 각 계수가 다른 변수를 고정한 채의 효과라는 점, 푸는 방법이 OLS인 이유, 변수를 무작정 늘릴 때 생기는 과적합까지 정리했습니다.
  • 회귀선과 평균선에서 벗어난 오차를 세로선으로 표시한 회귀 성능지표 산점도

    회귀 성능지표 5가지 — MAE·RMSE와 결정계수 R²까지

    2026년 09월 04일 통계·데이터

    회귀 성능지표는 만든 회귀식이 얼마나 잘 맞히는지 재는 잣대입니다. 단위가 살아있는 MAE, 비율로 보는 MAPE, 이론이 쓰는 MSE와 RMSE, 평균 대비 얼마나 나은지 보는 결정계수 R²까지 정리했습니다.
  • 단순선형회귀 회귀선과 각 점의 잔차를 세로선으로 표시한 산점도

    단순선형회귀란 무엇인가, 최소제곱법으로 회귀선 잡기

    2026년 09월 04일 통계·데이터

    단순선형회귀는 두 변수의 관계를 하나의 직선으로 요약해 예측하고 변수의 영향력까지 읽어내는 방법입니다. 오차와 잔차의 차이, 잔차제곱합을 최소로 만드는 최소제곱법, 기울기 해석까지 핵심만 정리했습니다.
  • 머신러닝이 데이터 속 패턴을 찾아 하나의 추세선으로 요약하는 과정을 나타낸 도식

    머신러닝이란 무엇인가 — 회귀·분류 2가지 예측 모델의 기초

    2026년 07월 25일 통계·데이터

    머신러닝은 데이터 속에 숨은 패턴을 찾아 수식으로 표현하고, 그 식으로 새 값을 예측하는 방법입니다. 공학 공식과 방향이 반대인 이유, 입력·출력 변수의 여러 이름, 출력의 형태가 회귀와 분류를 가르는 원리까지 정리했습니다.
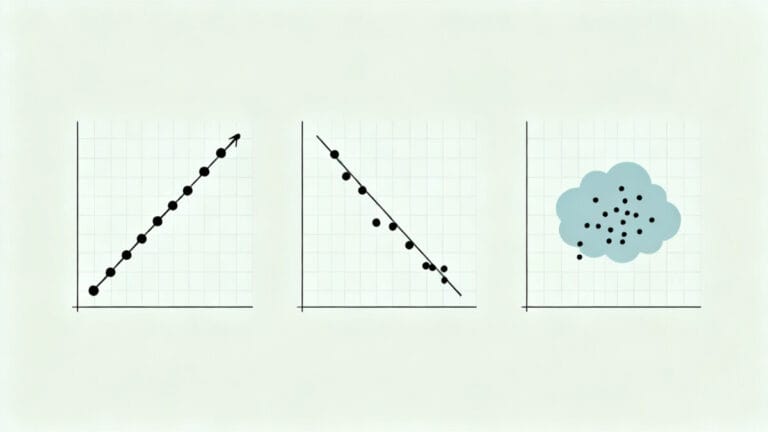
  • 상관분석의 세 가지 산점도 — 양의 상관, 음의 상관, 무상관을 나란히 보여주는 도식

    상관분석이란 무엇인가 — 공분산·상관계수 2가지로 관계 읽기

    2026년 07월 25일 통계·데이터

    상관분석은 두 변수가 같은 방향으로 움직이는지 방향과 세기를 읽는 방법입니다. 공분산이 왜 단위에 휘둘리는지, 그 단위를 지운 상관계수가 어떻게 -1에서 1 사이 값이 되는지, 왜 산점도를 반드시 함께 봐야 하는지 정리했습니다.
  • 등분산 검정이 ANOVA 앞의 문지기 역할을 하는 개념 인포그래픽

    등분산 검정 없이 ANOVA를 돌리면 생기는 일 — Bartlett·Levene 선택법 2가지

    2026년 07월 24일 통계·데이터

    등분산 검정은 여러 집단의 흩어짐이 같은지 확인하는 절차로, ANOVA의 전제를 지키는 문지기다. 정규분포면 Bartlett, 아니면 Levene — 두 검정의 선택 기준과 결과 해석, 전제가 깨졌을 때의 대응까지 정리했다.

  • 분산 검정의 핵심인 평균은 같아도 산포가 다른 두 과녁 비교 인포그래픽

    분산 검정: 평균이 같아도 안심할 수 없는 이유

    2026년 09월 04일 통계·데이터

    분산 검정은 평균이 아니라 흩어짐(산포)이 변했는지 확인하는 가설검정이다. 단일 집단은 카이제곱, 두 집단은 F검정 — 표본분산도 흔들리는 값이라는 직관부터 계측기 산포 비교 예시까지 2가지 절차로 정리했다.

  • 카이제곱 검정에서 분할표의 관측도수와 기대도수 차이를 비교하는 인포그래픽

    카이제곱 검정과 Fisher 정확검정, 분할표가 알려주는 갈림길

    2026년 08월 28일 통계·데이터

    카이제곱 검정은 불량률이 아주 작아 z검정을 못 쓸 때 분할표로 여러 집단의 비율을 비교하는 검정이다. 기대도수 계산법, ‘기대도수 5 미만 셀 20%’ 분기 조건, Fisher 정확검정으로 넘어가는 기준까지 예시로 정리했다.

  • 비율 검정으로 전체 생산품 중 불량 비율의 변화를 확인하는 인포그래픽

    비율 검정으로 불량률 논쟁 끝내기

    2026년 08월 28일 통계·데이터

    비율 검정은 불량률·합격률처럼 ‘전체 중 몇 개’가 변했는지 확인하는 가설검정이다. 불량 개수가 이항분포를 따르는 이유, 정규근사 조건 np·nq≥10, 두 집단 비교의 pooled 비율까지 4단계 예시로 정리했다.

  • 크루스칼 왈리스 검정의 세 집단 순위 비교 원리를 표현한 인포그래픽

    크루스칼 왈리스 검정 — ANOVA가 막힐 때 3개 집단을 비교하는 법

    2026년 07월 24일 통계·데이터

    크루스칼 왈리스 검정은 데이터가 비정규이고 표본이 적어 ANOVA를 못 쓸 때, 순위로 3개 이상 집단을 한 번에 비교하는 비모수 검정이다. H 통계량이 카이제곱 분포를 따르는 구조와 판정 4단계를 쉬운 예시로 정리했다.

Page navigation

Previous PagePrevious 1 2 3 4 … 15 Next PageNext

카테고리

  • AI · AX
    • 실전 · 워크플로우
    • 인사이트 · 전환
  • AI 산업 인사이트
  • Domain
    • 엔지니어 마인드셋
    • 현장 엔지니어링
  • series
    • 웹·백엔드(Django)
    • 통계·데이터
    • 파이썬 데이터분석

Copyright © 2026 deepcarpenter | Build Deep, Think Deeper.
Wordpress Theme by 워플:WPlaybook.

  • 개인정보처리방침
  • 이용약관
  • 홈
  • AI · AX
    • 실전 · 워크플로우
    • 인사이트 · 전환
  • Domain
    • 현장 엔지니어링
    • 엔지니어 마인드셋
  • series
    • 파이썬 데이터분석
    • 통계·데이터
    • 웹·백엔드(Django)
  • 블로그
  • 문의하기
  • About