분산 검정: 평균이 같아도 안심할 수 없는 이유
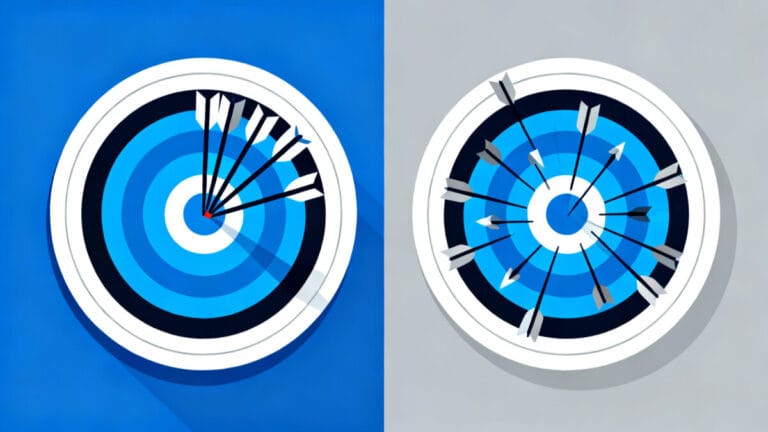
분산 검정은 평균이 아니라 흩어짐(산포)이 변했는지 확인하는 가설검정이다. 단일 집단은 카이제곱, 두 집단은 F검정 — 표본분산도 흔들리는 값이라는 직관부터 계측기 산포 비교 예시까지 2가지 절차로 정리했다.
분산 검정은 평균이 아니라 흩어짐(산포)이 변했는지 확인하는 가설검정이다. 단일 집단은 카이제곱, 두 집단은 F검정 — 표본분산도 흔들리는 값이라는 직관부터 계측기 산포 비교 예시까지 2가지 절차로 정리했다.

카이제곱 검정은 불량률이 아주 작아 z검정을 못 쓸 때 분할표로 여러 집단의 비율을 비교하는 검정이다. 기대도수 계산법, ‘기대도수 5 미만 셀 20%’ 분기 조건, Fisher 정확검정으로 넘어가는 기준까지 예시로 정리했다.

비율 검정은 불량률·합격률처럼 ‘전체 중 몇 개’가 변했는지 확인하는 가설검정이다. 불량 개수가 이항분포를 따르는 이유, 정규근사 조건 np·nq≥10, 두 집단 비교의 pooled 비율까지 4단계 예시로 정리했다.
크루스칼 왈리스 검정은 데이터가 비정규이고 표본이 적어 ANOVA를 못 쓸 때, 순위로 3개 이상 집단을 한 번에 비교하는 비모수 검정이다. H 통계량이 카이제곱 분포를 따르는 구조와 판정 4단계를 쉬운 예시로 정리했다.

윌콕슨 검정은 표본이 30개 미만이고 정규분포도 아닐 때 값 대신 순위로 비교하는 비모수 검정이다. 단일 집단용 Signed-Rank와 두 집단용 Rank-Sum의 원리, 왜 중앙값 검정인지, 평균 비교로 써도 되는 조건까지 정리했다.

분산분석(ANOVA)은 세 집단 이상의 평균을 한 번에 비교하는 검정이다. 평균 비교인데 왜 이름이 분산분석인지, F값이 ‘집단 사이 흩어짐 ÷ 집단 안 흩어짐’이라는 직관, 등분산 전제와 박스플롯 활용까지 정리했다.

t검정은 표본이 30개 미만이라 표본분산을 믿기 어려울 때 쓰는 평균 비교 검정이다. t분포의 두꺼운 꼬리가 왜 ‘겸손함’인지, 자유도가 왜 n−1인지, p값이 0.05 근처일 때 어떻게 판단하는지까지 4단계로 정리했다.

z검정은 표본 30개 이상일 때 평균 변화를 확인하는 가장 기본적인 가설검정이다. z값이 ‘평균에서 몇 계단 떨어졌나’라는 뜻임을 잡으면 공식이 외워진다. 계산 4단계와 두 집단 비교까지 예시로 정리했다.

가설검정 절차는 어떤 검정이든 4단계로 같고, 바뀌는 건 검정통계량과 샘플링 분포뿐이다. 정규성·표본 크기·집단 수 질문 3개로 z·t·ANOVA·비모수·카이제곱 중 무엇을 쓸지 고르는 분류도를 한 장에 정리했다.
웹 프레임워크 선택, FastAPI·Django·Flask 중 뭐가 맞을지 고민된다면 여기서 기준을 잡을 수 있다. 성능·자유도·구조 3가지 기준으로 비교하고, 상황별 선택 기준과 Streamlit·프론트엔드 활용법까지 실무 관점에서 한 번에 정리했다.