판다스 데이터 전처리 4단계 흐름 — 개념만 알면 AI 요청이 완성된다
판다스 데이터 전처리를 4단계 흐름으로 정리했다. concat·merge·정렬·요약의 순서와 각 단계에서 AI에게 요청하는 법을 개념 중심으로 설명한다.
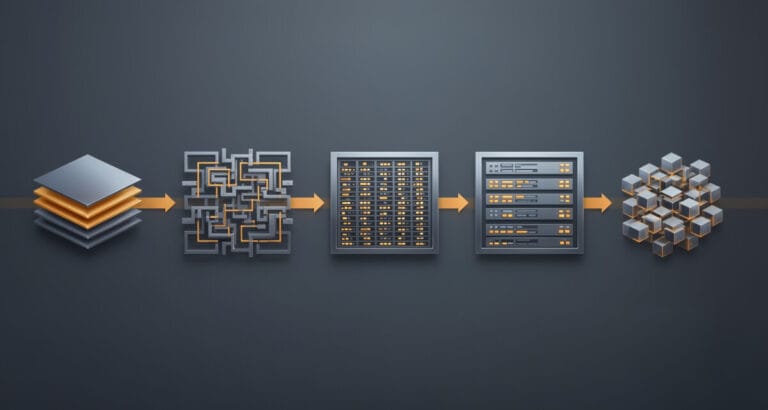
판다스 데이터 전처리를 4단계 흐름으로 정리했다. concat·merge·정렬·요약의 순서와 각 단계에서 AI에게 요청하는 법을 개념 중심으로 설명한다.
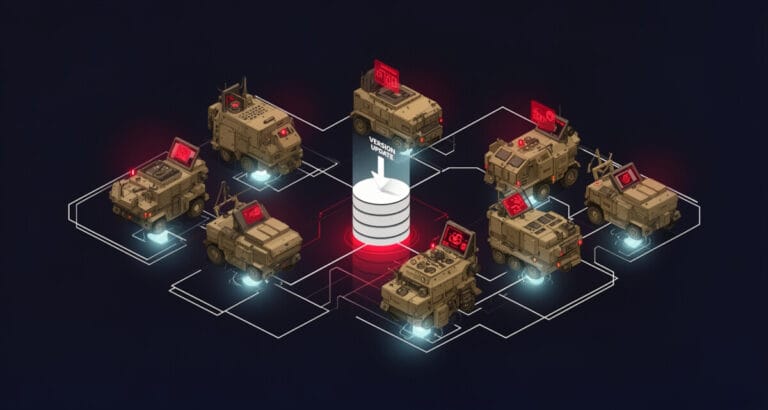
마이그레이션 이란 DB 구조 변경을 코드 파일로 기록해 버전 단위로 추적하는 작업이다. 인터넷 차단·보안 제약 환경에서 어떻게 작동하는지, Django가 이 문제를 어떻게 자동화하는지 야전 시나리오로 이해할 수 있다.
pandas 데이터프레임은 행과 열로 구성된 2차원 표 구조로 엑셀보다 빠르고 코드로 자유롭게 조작된다. 생성·입출력·조회·결측치·수정 5가지 핵심 영역을 단계별로 이해하면 데이터 분석 전체 흐름이 한눈에 보인다.
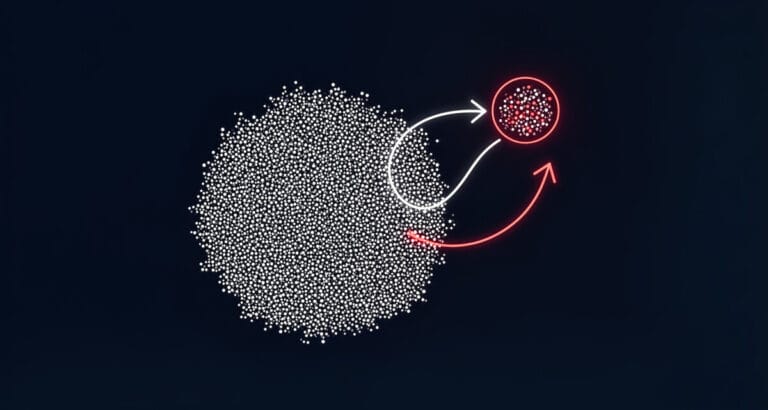
모집단 표본의 핵심은 모집단을 전부 알 수 없어서 표본으로 모수를 추정한다는 것이다. 데이터 종류 3가지, 기술통계 vs 추론통계, 모수 추정과 가설 검정이 왜 통계학의 두 축인지 단계별로 이해할 수 있다.
AI 역사의 흐름을 따라가면 AI·ML·딥러닝·통계학의 관계와 차이가 선명해진다. 1800년대 통계학부터 ChatGPT까지의 연대기와 통계학(추론) vs 머신러닝(예측)의 핵심 차이를 이해하면 데이터 사이언스 전체 지형이 보인다.
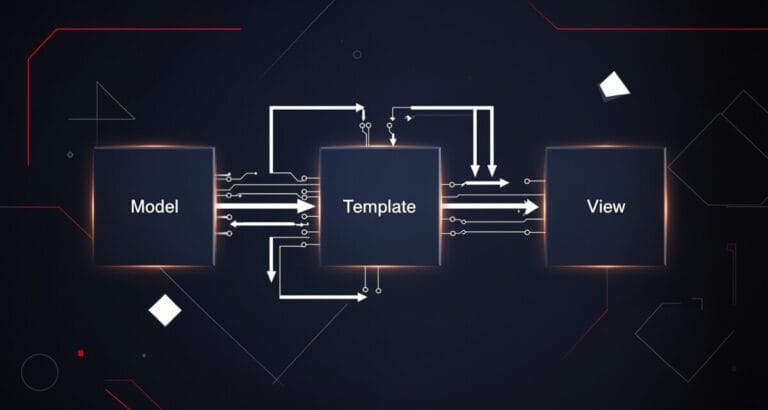
웹 프레임워크는 반복되는 구조와 규칙을 미리 제공하는 벤대로, 라이브러리와 달리 제어권이 프레임워크에 있다. Django가 좋은 3가지 이유, MTV 패턴의 역할 구분, 프레임워크를 고르는 기준까지 한 번에 잡을 수 있다.
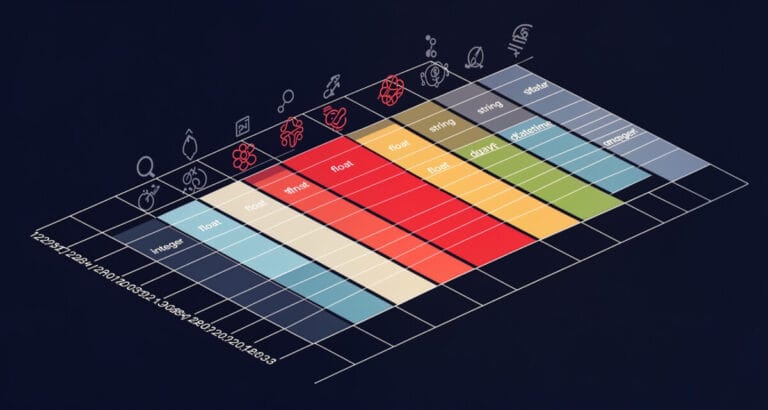
pandas DataFrame은 여러 자료형을 하나의 표에 담는 2차원 데이터 컨테이너다. numpy 배열과의 차이, 딕셔너리·리스트·시계열로 만드는 3가지 방법, 속성 조회 5가지와 콜럼 삭제 방법까지 익히면 판다스 기초 활용이 완성된다.
pandas 인덱싱에서 loc과 iloc의 차이는 레이블 기준인지 정수 위치 기준인지에 있다. 범위·비연속 접근, 단일값 at·iat, 불리언 필터링까지 각 방법의 쓰임새를 구분해두면 AI에게 정확한 데이터 요청이 가능해진다.
표본 분포는 랜덤 샘플링한 표본들의 분포이며 표본이 커질수록 표본 평균이 모 평균에 수렴한다. 평균·중앙값·최빈값, 분산·표준편차, IQR·왼도·첨도까지 핵심 통계 지표를 한 번에 정리했다.
판다스 Series는 값에 인덱스 레이블을 붙인 1차원 구조다. NumPy와의 차이, Series 생성 3가지 방법, 인덱싱, 결측치 처리(isnull·notnull)까지 한 번에 정리한다.