pandas 전처리 완전 정복 — 파일 입출력부터 인덱싱까지 한 번에 잡는 5단계
pandas 전처리의 핵심 5단계를 한 번에 정리했다. CSV·엑셀 파일 입출력부터 결측값 처리, loc·iloc 인덱싱, 조건 필터링, 행·열 삭제까지 — 데이터 분석 전에 반드시 잡아야 할 pandas 전처리 흐름을 실전 코드와 함께 설명한다.
pandas 전처리의 핵심 5단계를 한 번에 정리했다. CSV·엑셀 파일 입출력부터 결측값 처리, loc·iloc 인덱싱, 조건 필터링, 행·열 삭제까지 — 데이터 분석 전에 반드시 잡아야 할 pandas 전처리 흐름을 실전 코드와 함께 설명한다.
판다스 결측치인 NaN·None·NA가 섞인 채 분석하면 결과가 틀리거나 에러가 난다. 각각의 차이, dropna·fillna 사용법, loc·iloc까지 이해하면 AI에게 정확한 데이터 처리를 요청할 수 있게 된다.
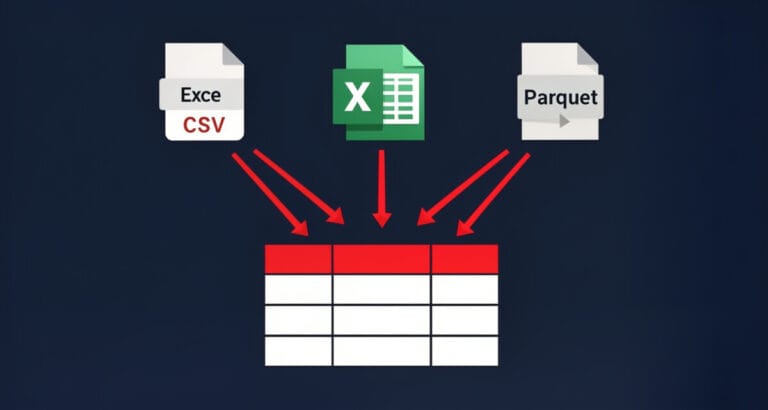
판다스 dataframe으로 CSV·Excel·Parquet 파일을 불러오는 방법과 인코딩 오류 해결법, float64·float32 타입 변환까지 3단계로 정리했다. 파이썬 데이터 분석 첫 단계를 완전히 잡고 싶은 엔지니어라면 이 글부터 시작하자.
판다스 데이터 전처리를 4단계 흐름으로 정리했다. concat·merge·정렬·요약의 순서와 각 단계에서 AI에게 요청하는 법을 개념 중심으로 설명한다.
지식 아카이브란 조직의 노하우를 검색 가능한 형태로 보존하는 구조다. RAG 챗봇과 연결하면 베테랑의 판단 기준을 누구든 꺼내 쓸 수 있다. 수집·구조화·검색 3단계 흐름을 한 번에 정리했다.
마이그레이션 이란 DB 구조 변경을 코드 파일로 기록해 버전 단위로 추적하는 작업이다. 인터넷 차단·보안 제약 환경에서 어떻게 작동하는지, Django가 이 문제를 어떻게 자동화하는지 야전 시나리오로 이해할 수 있다.
pandas 데이터프레임은 행과 열로 구성된 2차원 표 구조로 엑셀보다 빠르고 코드로 자유롭게 조작된다. 생성·입출력·조회·결측치·수정 5가지 핵심 영역을 단계별로 이해하면 데이터 분석 전체 흐름이 한눈에 보인다.
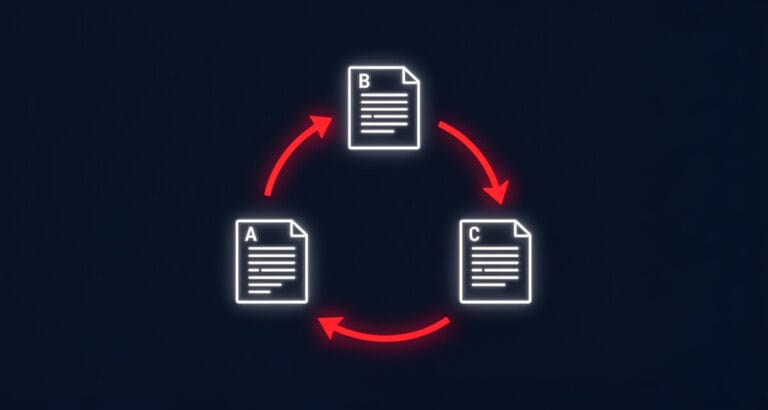
재귀적 분석이란 AI가 코드 A→B→C→A로 참조를 타고 들어가며 전체 구조를 파악하는 방식이다. 동작하는 코드 한 줄이 설명 열 줄보다 정확하다는 원리를 이해하면 AI에게 코드를 넘기는 방식이 달라진다.
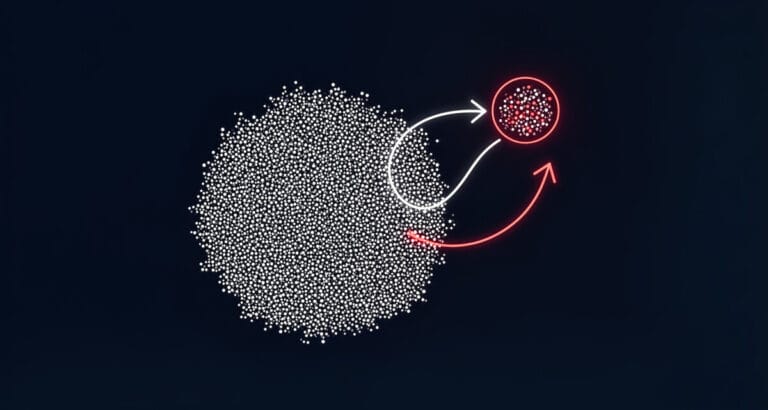
모집단 표본의 핵심은 모집단을 전부 알 수 없어서 표본으로 모수를 추정한다는 것이다. 데이터 종류 3가지, 기술통계 vs 추론통계, 모수 추정과 가설 검정이 왜 통계학의 두 축인지 단계별로 이해할 수 있다.
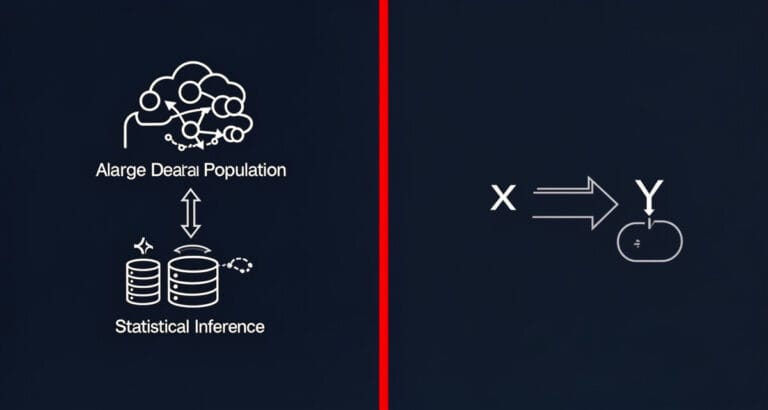
AI 역사의 흐름을 따라가면 AI·ML·딥러닝·통계학의 관계와 차이가 선명해진다. 1800년대 통계학부터 ChatGPT까지의 연대기와 통계학(추론) vs 머신러닝(예측)의 핵심 차이를 이해하면 데이터 사이언스 전체 지형이 보인다.