기댓값이란 무엇인가 — 모평균과 똑같은 값이 되는 3가지 원리
기댓값이란 무엇인가? 실험을 무한 반복했을 때의 평균인 기댓값이 모평균과 똑같은 값이 되는 원리부터 두 가지 계산법, 평균이라서 통하는 연산 규칙, 분산까지 기댓값으로 표현되는 구조를 현장 엔지니어의 언어로 정리했다. 통계 개념을 수식이 아니라 직관으로 잡고 싶다면 확인해보자.

기댓값이란 무엇인가? 실험을 무한 반복했을 때의 평균인 기댓값이 모평균과 똑같은 값이 되는 원리부터 두 가지 계산법, 평균이라서 통하는 연산 규칙, 분산까지 기댓값으로 표현되는 구조를 현장 엔지니어의 언어로 정리했다. 통계 개념을 수식이 아니라 직관으로 잡고 싶다면 확인해보자.
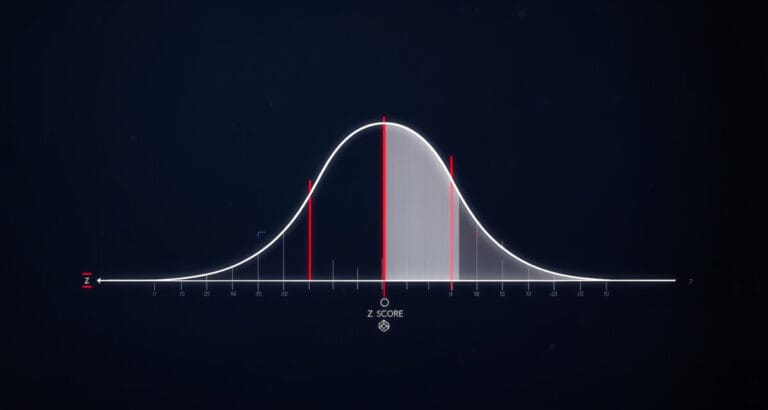
연속확률분포에서는 특정 값의 확률을 구간 적분으로만 정의할 수 있다. 정규분포의 구조, Z 변환, 이항→정규 근사 조건, 지수분포까지 차례로 짚으면 데이터 분석에 필요한 통계 기반이 탄탄해진다.
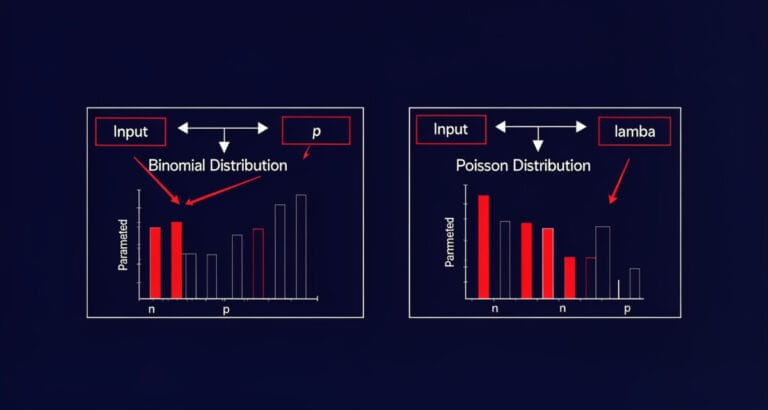
이산확률분포의 두 축, 이항분포와 포아송분포를 매개변수 개념부터 정리했다. n·p·λ가 왜 필요한지 모르면 공식이 남지 않는다. 현장 엔지니어 언어로 개념을 완전히 잡는 법을 확인해보자.
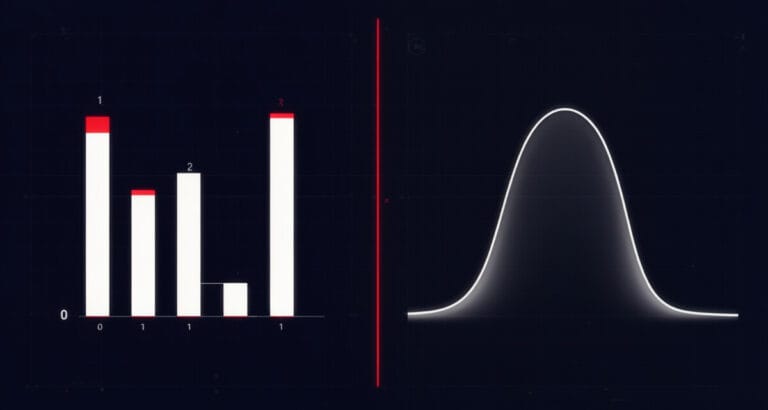
확률변수 종류는 이산형과 연속형으로 나뉘며, 이 구분에 따라 확률 계산 방식이 완전히 달라진다. 확률밀도함수와 누적확률분포까지 현장 엔지니어 언어로 한 흐름에 정리했다.

모수는 존재하지만 알 수 없다 — 그래서 통계학이 있다. 모수 뜻 한 줄 정의에서 멈추지 않고, 모집단을 어떻게 정의하느냐에 따라 분포가 달라지는 실무 포인트, 이상치가 있을 때 평균·중앙값 선택 기준, 4가지 모수 분류표까지 제조 현장 예시로 정리했다.
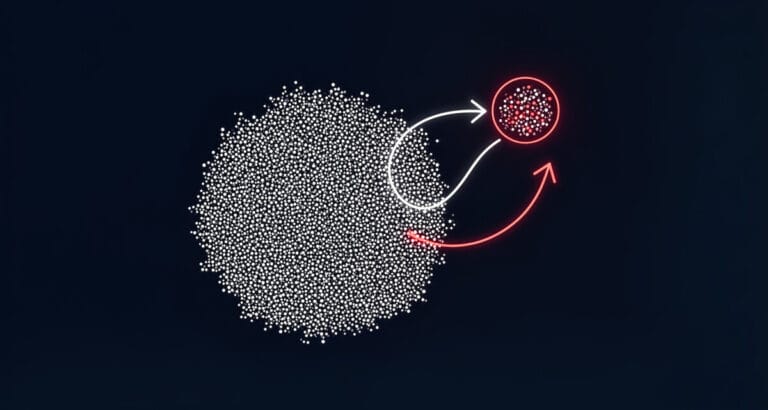
모집단 표본의 핵심은 모집단을 전부 알 수 없어서 표본으로 모수를 추정한다는 것이다. 데이터 종류 3가지, 기술통계 vs 추론통계, 모수 추정과 가설 검정이 왜 통계학의 두 축인지 단계별로 이해할 수 있다.
AI 역사의 흐름을 따라가면 AI·ML·딥러닝·통계학의 관계와 차이가 선명해진다. 1800년대 통계학부터 ChatGPT까지의 연대기와 통계학(추론) vs 머신러닝(예측)의 핵심 차이를 이해하면 데이터 사이언스 전체 지형이 보인다.
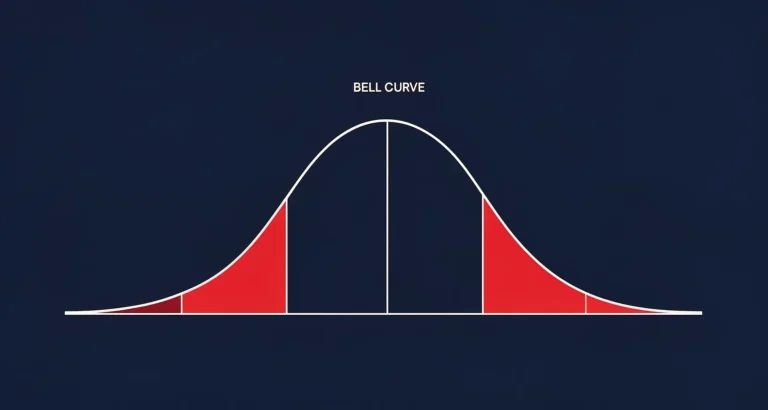
표본 분포는 랜덤 샘플링한 표본들의 분포이며 표본이 커질수록 표본 평균이 모 평균에 수렴한다. 평균·중앙값·최빈값, 분산·표준편차, IQR·왼도·첨도까지 핵심 통계 지표를 한 번에 정리했다.
자유도 통계는 n-1이라는 공식이 아니다. 제약 조건이 생길 때마다 독립적인 값이 줄어드는 원리, t분포·F분포의 모양이 바뀌는 이유를 현장 엔지니어 언어로 한 번에 정리했다.
회귀분석이란 숫자를 예측하는 머신러닝 작업이다. 코딩보다 도메인 지식이 먼저인 이유 3가지를 F1 엔지니어링 시나리오로 풀어본다. 현장 엔지니어라면 이미 출발선이 다르다.