F1 레이스에서 이런 상황을 상상해보자.
레이스 팀이 타이어 교체 시점을 결정하기 위해 센서 데이터를 수집한다. 랩마다 타이어 마모 수치를 측정하는데, 같은 타이어인데도 매 랩 수치가 조금씩 다르게 나온다. 10랩치 평균을 내면 68.2mm, 다음 10랩치 평균을 내면 67.9mm. 이 평균값들은 왜 매번 조금씩 다를까.
이 질문에 답할 수 있다면, 가설검정 교재에 나오는 그 두 개의 정규분포 그래프가 무엇인지 자연스럽게 이해된다. 표본 분포 개념이 그 열쇠다. 가설검정을 배울 때 가장 많이 막히는 지점이 바로 여기다 — “H₀이 참일 때 표본 분포”라는 문장이 대체 무슨 뜻인가. 이 글에서 그 개념을 처음부터 차근차근 풀어낸다.
표본 분포의 출발점 — 표본 평균은 왜 매번 다른가
먼저 근본적인 질문을 짚고 가자. 데이터를 수집할 때, 매번 똑같은 결과가 나오는가?
그렇지 않다. 같은 공정, 같은 설비에서 측정해도 수치는 항상 조금씩 흔들린다. 이것은 측정 오차나 설비 문제가 아니다. 자연적인 변동이다.
아래 수치는 개념 설명을 위한 임의의 수치입니다.
타이어 마모 데이터를 예로 들면, 개별 측정값(X)은 평균 68mm를 중심으로 퍼진 정규분포를 따른다고 가정할 수 있다. 개별 측정값 하나하나는 흔들린다. 그런데 여기서 중요한 질문이 나온다.
“10개씩 묶어서 평균을 내면 어떻게 될까?”
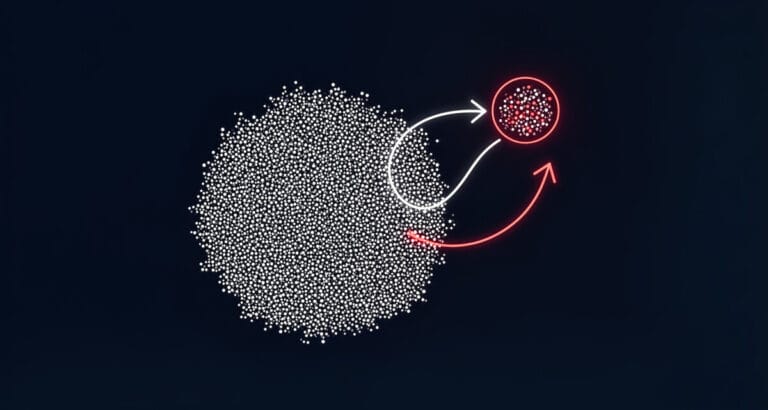
10개를 뽑아서 평균을 내면 하나의 숫자(X̄)가 나온다. 이걸 다시 10개 뽑아서 평균을 내면 또 다른 숫자가 나온다. 이 평균값들을 수백 번 반복해서 모아보면, 그 평균값들 자체가 하나의 분포를 이룬다.
이것이 표본 분포다. 표본 평균(X̄)들의 분포.
표본 분포는 개별 데이터 분포와 무엇이 다른가
개별 타이어 마모값(X)의 분포와, 10개씩 묶은 평균값(X̄)의 샘플링 분포는 모양이 다르다.
| 구분 | 평균(중심) | 분산(퍼짐) |
|---|---|---|
| 개별 측정값 X | μ (모집단 평균) | σ² |
| 표본 평균 X̄ (n=10) | μ (동일) | σ²/10 |
| 표본 평균 X̄ (n=100) | μ (동일) | σ²/100 |
중심(평균)은 같다. 그런데 퍼짐(분산)은 표본 크기 n으로 나눠진다. n이 클수록 이 분포는 좁고 뾰족해진다.
F1 예시로 설명하면, 랩 1개짜리 타이어 평균과 랩 30개짜리 타이어 평균 중 어느 쪽이 더 안정적일까. 당연히 30개 랩의 평균이 훨씬 안정적이다. 개별 수치의 흔들림이 평균으로 상쇄되기 때문이다. 표본이 많을수록 곡선이 좁아지는 것이 바로 이 원리다.
이것은 검정력 유의수준에서 표본 크기가 클수록 오류가 줄어드는 이유와 정확히 연결된다.
“H₀이 참일 때 표본 평균의 분포” — 이제 이 문장이 보인다
이제 다시 가설검정 그래프로 돌아가자.
F1 레이싱 Engineering 사례는 설명을 위해 구성한 가상의 시나리오다.
실제 특정 팀이나 드라이버의 데이터를 기반으로 한 것이 아님을 밝혀 둔다.
- H₀ (귀무가설): 타이어 마모 평균은 정상 범위다 (μ = 68mm)
- H₁ (대립가설): 타이어 마모 평균이 한계를 넘었다 (μ > 68mm)
“H₀이 참일 때 표본 분포”라는 말은 이런 뜻이다.
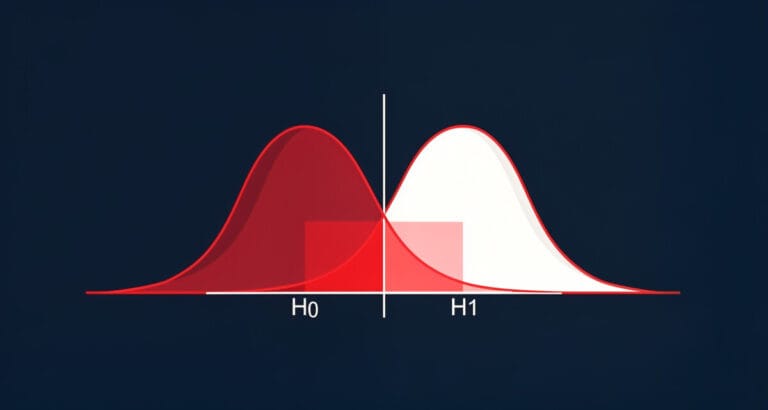
“만약 타이어 마모의 진짜 모집단 평균이 68mm라면, n개씩 표본을 뽑아서 평균을 낼 때, 그 평균값들은 68mm를 중심으로 이런 형태로 분포할 것이다.”
즉 이것은 가정 위에 그린 곡선이다. “H₀이 참이라면 표본 평균이 이렇게 분포할 것”이라는 전제 하에 그린 그래프다.
마찬가지로 “H₁이 참일 때의 곡선”은 이런 뜻이다.
“만약 타이어 마모의 진짜 평균이 실제로 한계를 넘었다면, 표본 평균들은 더 오른쪽에서 이런 형태로 분포할 것이다.”
그런데 여기서 결정적인 포인트가 있다. H₁의 곡선이 실제로 어디 있는지는 아무도 모른다. 진짜 모집단 평균이 얼마인지 알고 있다면, 처음부터 가설검정이 필요 없다. 교재의 두 번째 곡선은 “만약 H₁이 참이라면 표본 평균이 이 근방에 있을 것”이라는 설명용 가정이다.
두 분포가 겹치는 이유 — 불확실성의 시각화
H₀ 곡선과 H₁ 곡선이 겹치는 이유는 표본 평균의 변동성 때문이다.
F1 팀이 10랩치 평균을 냈더니 68.8mm가 나왔다고 하자. 이 수치는 H₀ 분포(평균 68mm)에서도 나올 수 있고, H₁ 분포(평균 70mm라고 가정했을 때)에서도 나올 수 있다. 평균값 자체가 퍼짐을 갖기 때문이다.
그 겹치는 영역이 바로 오류가 발생하는 구간이다. 1종 오류와 2종 오류는 바로 이 겹침 때문에 생긴다.
표본 크기 n을 늘리면 두 곡선이 각각 뾰족해지고 겹치는 면적이 줄어든다. 판정이 명확해진다.
| 표본 크기 | 곡선 모양 | 두 분포 겹침 | 판정 오류 |
|---|---|---|---|
| 작음 (n=5) | 넓고 완만 | 많이 겹침 | 크다 |
| 중간 (n=30) | 중간 | 적당히 겹침 | 중간 |
| 큼 (n=100) | 좁고 뾰족 | 거의 안 겹침 | 작다 |
“표본 크기가 클수록 가설검정이 신뢰성 있다”는 말의 진짜 의미가 바로 이것이다. 곡선이 좁아질수록 겹침이 줄어들고, 판정 오류가 감소한다.
핵심 요약
표본 분포를 이해하면 가설검정 그래프의 구조가 한 번에 정리된다.
| 핵심 개념 | 내용 |
|---|---|
| 표본 분포 | 표본 평균(X̄)들이 모여서 이루는 분포 |
| 분산 공식 | σ²/n — n이 클수록 곡선이 좁아진다 |
| H₀ 곡선 | H₀이 맞다는 가정 하에 그린 표본 평균의 분포 |
| H₁ 곡선 | 설명용 가정 — 실제 위치는 알 수 없다 |
| 두 곡선의 겹침 | 오류 발생 구간 — 표본 크기로 줄일 수 있다 |
이전 포스팅에서 다룬 1종·2종 오류와 α·β 트레이드오프가 왜 그 모양으로 생겼는지, 이제 이 그림을 보면서 직접 느낄 수 있을 것이다. 두 개념을 함께 보면 가설검정 전체 구조가 한 번에 정리된다.
표본 분포 개념을 잡았다면, 가설검정의 전체 의사결정 구조를 한 번에 정리할 차례다.
이 개념의 전제가 되는 귀무가설·대립가설 설정이 아직 익숙하지 않다면 이 글부터 읽자.