두 드라이버의 평균 랩타임이 똑같다고 하자. 성적표의 평균만 보면 둘은 동급이다. 그런데 한 명은 매 랩 거의 같은 타임으로 일정하게 돌고, 다른 한 명은 랩마다 빨랐다 느렸다 들쭉날쭉하다. 결승에서 믿고 맡길 드라이버는 평균이 아니라 이 흩어짐이 가른다. 분산 검정은 바로 그 흩어짐(산포)이 달라졌는지를 판정하는 도구다.
공정 데이터도 똑같다. 평균이 기준에 딱 맞아도 값이 넓게 흩어지기 시작하면, 규격 경계를 벗어나는 값이 늘어나며 품질 문제가 시작된다. 그래서 평균 관리 못지않게 산포 관리가 중요하고, 산포가 정말 변했는지를 판정하는 절차가 분산 검정이다. 이 글에서는 집단 1개짜리 카이제곱 검정과 집단 2개짜리 F검정, 2가지를 다룬다.
분산 검정은 분류도의 어느 자리인가
가설검정 절차 분류도의 세 번째 장, 분산 트리다.
| 데이터가 종 모양인가 | 집단 수 | 사용할 검정 |
|---|---|---|
| 그렇다 | 1개 | 카이제곱 검정 |
| 그렇다 | 2개 | F검정 |
| 그렇다 | 여러 개 (ANOVA 사전 확인) | Bartlett 검정 |
| 아니다 | 여러 개 | Levene 검정 |
이 글은 위 두 줄을 다루고, 아래 두 줄(Bartlett·Levene)은 다음 글에서 이어간다. 참고로 여기서 확인하려는 모분산은 모집단의 진짜 흩어짐 — 우리가 영영 직접 볼 수 없는 모수다. 그래서 이번에도 표본으로 우회한다.
출발점 — 표본분산도 흔들리는 값이다
시리즈 내내 반복한 프레임을 다시 소환하자. 절차는 늘 같고, 검정마다 바뀌는 것은 통계량과 그 분포뿐이다. 분산 검정의 재료는 표본분산 s²이다.
여기서 잡아야 할 직관이 하나 있다. 표본분산도 표본을 다시 뽑으면 매번 다르게 나오는, 흔들리는 값이라는 점이다. 표본평균이 흔들리듯 표본분산도 흔들린다. 흔들리는 값이니 분포를 가지고, 분포가 있으니 검정통계량의 재료가 될 수 있다.
단일 집단에서 “모분산이 믿어온 값 σ₀²과 같은가”를 물을 때의 통계량은 이것이다.
χ² = (n−1) × s² ÷ σ₀²
말로 풀면 “표본에서 계산한 흩어짐이, 믿어온 흩어짐의 몇 배인가”를 (n−1배 규모로) 잰 값이다. 믿음이 맞다면 s²과 σ₀²이 비슷해서 이 값은 자유도 n−1 근처에 온다. 이 값이 따르는 분포가 자유도 n−1의 카이제곱 분포 — 분할표에서 만났던 그 분포가 여기서 또 나온다. 자유도가 n−1인 이유는 표본분산 계산에 표본평균을 이미 썼기 때문으로, 자유도 글의 원리 그대로다.
단일 집단 분산 검정 — 예시로 밟아보기
아래 수치는 개념 설명을 위한 임의의 수치입니다.
기준값 100 근처에서 도는 공정. 오랫동안 분산 4(표준편차 2)로 믿어왔는데, 요즘 값이 널뛰는 느낌이다. 표본 25개를 뽑았더니 표본분산 6.4가 나왔다.
| 단계 | 내용 | 이 예시에서 |
|---|---|---|
| 1 | 가설 세우기 | 귀무가설 “분산은 4다” vs 대립가설 “4가 아니다” (양측) |
| 2 | 기준선 정하기 | 유의수준 0.05 |
| 3 | 통계량 계산 | χ² = 24 × 6.4 ÷ 4 = 38.4 (자유도 24) |
| 4 | p값 판정 | 양측 p ≈ 0.06 > 0.05 → 귀무가설 유지, 단 경계 근처 |
판정은 “분산이 변했다고 볼 근거 부족”이지만, p값이 0.06으로 기준선에 바짝 붙었다. t검정 글에서 말한 원칙이 여기서도 그대로 적용된다 — 경계 근처의 p값은 단정하지 말고, 표본을 늘려 재검정하는 것이 정답이다. 산포는 한번 벌어지기 시작하면 방치 비용이 크므로, 이런 애매한 신호일수록 데이터를 더 모을 가치가 있다.
F검정 — 두 집단의 산포를 비율로 비교한다
계측기를 새로 들였다고 하자. 새 계측기가 기존 계측기만큼 일관된 값을 주는지 — 즉 측정의 흩어짐이 같은지 — 확인하고 싶다. 측정기가 흔들리면 그 위의 모든 판단이 흔들리므로, 계측 신뢰성 관리에서 이 질문은 핵심이다.
두 집단의 F검정 통계량은 놀랄 만큼 단순하다.
F = s₁² ÷ s₂²
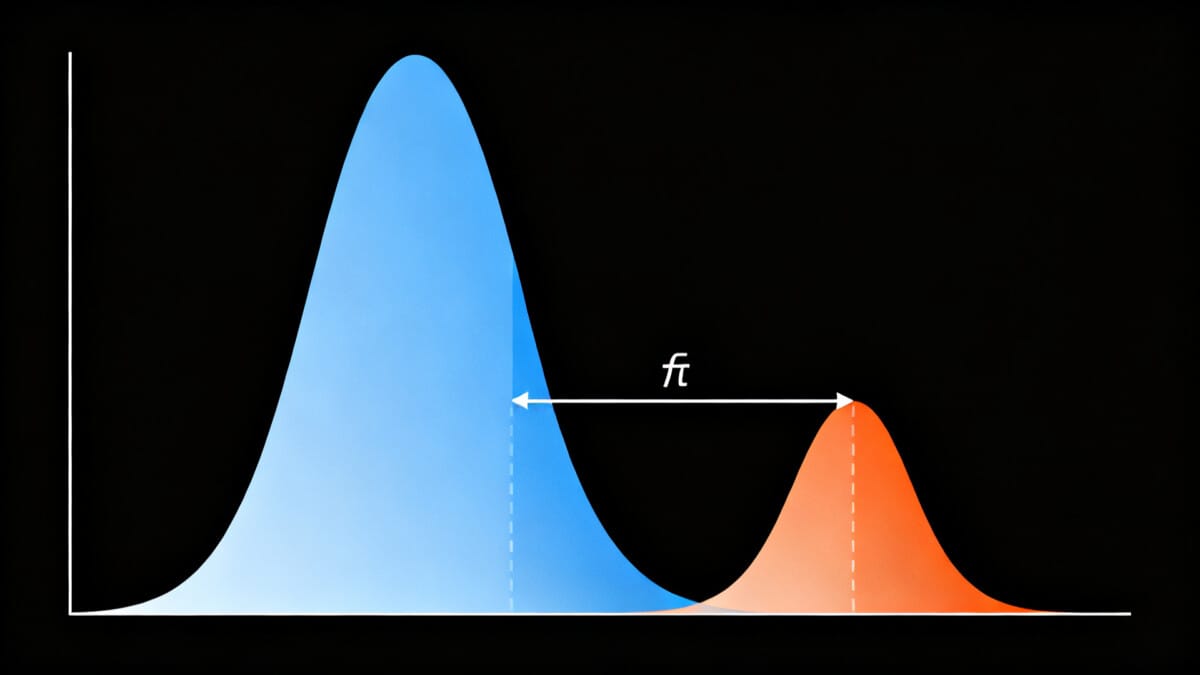
두 표본분산의 비율이다. 왜 모분산이 공식에 없을까? 귀무가설(“두 모분산은 같다”)이 참이라면 분자·분모의 모분산이 서로 지워지기 때문이다. 같다고 가정하는 순간 비교는 표본분산끼리의 비율로 충분해지고, 이 비율이 1에서 얼마나 벗어났는지만 보면 된다. F분포는 분산분석에서 만났던 그 분포이고, 자유도 두 개(n₁−1, n₂−1)를 가진다.
기존 계측기 16개 측정에서 s² = 5, 새 계측기 21개 측정에서 s² = 3이 나왔다면 F = 5 ÷ 3 ≈ 1.67, 자유도 (15, 20)에서 p ≈ 0.28. 기준선보다 훨씬 크므로 “두 계측기의 산포가 다르다고 볼 근거 없음” — 새 계측기를 안심하고 투입할 수 있다는 뜻이다.
프레임은 여기서도 똑같다
이 시리즈에서 다섯 번째 반복이지만, 분산 검정만큼 이 말이 선명한 곳이 없다. 가설을 세우고, 기준선을 정하고, 통계량을 계산하고, 분포에서 p값을 읽는다 — 절차는 한 글자도 안 바뀌었다. 바뀐 것은 통계량이 (n−1)s²/σ₀²이나 s₁²/s₂²이라는 것, 그리고 판정 분포가 카이제곱·F분포라는 것뿐이다. 통계량과 분포, 이 두 가지만 갈아 끼우면 어떤 대상이든 같은 프레임으로 검정할 수 있다.
평균은 비슷한데 산포가 3.6배였다
이 블로그의 검색 성과 데이터로 F검정을 직접 돌려봤다. 2026년 8월 17일 수집 기준이고, 아래 숫자는 예시가 아니라 실측값이다.
비교한 것은 두 카테고리 글의 검색 평균 게재순위다. 노출이 발생한 글만 골라, 통계·데이터 20편과 파이썬 데이터분석 19편을 놓고 봤다.
| 구분 | 통계·데이터 | 파이썬 데이터분석 |
|---|---|---|
| 글 수 | 20편 | 19편 |
| 평균 게재순위 | 9.05위 | 7.15위 |
| 표본분산 | 15.73 | 4.32 |
평균만 보면 두 자리도 차이 나지 않는다. 그런데 분산은 3.6배다. 파이썬 글은 대부분 7위 근처에 몰려 있고(3.5~14.3위), 통계 글은 5위권부터 19위권까지 흩어져 있다. 평균만 보고 “비슷하네”라고 넘어갔다면 어떤 글은 이미 잘 되고 있고 어떤 글은 손도 못 댔다는 사실을 놓쳤을 것이다. 다음에 무엇을 고칠지 고르는 데 필요한 정보는 평균이 아니라 분산 쪽에 있었다.
여기까지는 그냥 기술통계다. 그럼 F검정으로 넘어가 보자. F = 15.73 ÷ 4.32 = 3.64이고, 자유도 (19, 18)에서 양측 5% 임계값이 2.576이니 기각역 안이다(p = 0.0084). 산포가 같다는 가설을 버리라는 결과다.
그런데 이 결과를 그대로 믿으면 안 된다. F검정은 두 집단이 정규분포를 따른다는 전제 위에 서 있는데, 이 데이터에 정규성 검정을 해보면 두 집단 모두 기각된다(p = 0.0009와 0.0004). 전제가 깨진 채로 나온 p값이다. 실제로 정규성에 덜 민감한 Levene 검정을 돌리면 p = 0.076으로 기각하지 못한다. 정규성을 전제하는 Bartlett 검정만 p = 0.0083으로 기각한다.
정리하면 이렇다. 분산이 3.6배라는 관찰은 사실이지만, 20편 대 19편이라는 표본으로 “모집단의 산포가 다르다”고 단정할 수는 없다. F검정이 기각했다고 안심하면, 이 글이 경고한 함정을 한 단계 위에서 똑같이 밟는 것이다. 평균만 보고 안심하는 대신 전제를 확인하지 않은 p값을 보고 안심하는 것일 뿐이다. 검정을 고르기 전에 전제부터 보는 이유는 등분산 검정 없이 ANOVA를 돌리면 생기는 일에서 더 다뤘다.
핵심 요약
- 분산 검정은 평균이 아니라 흩어짐(산포)의 변화를 판정한다 — 산포 관리의 통계적 기초
- 표본분산 s²도 흔들리는 값이라 분포를 가진다
- 단일 집단: χ² = (n−1)s²/σ₀², 자유도 n−1의 카이제곱 분포
- 두 집단: F = s₁²/s₂², 귀무가설이 참이면 모분산이 지워져 비율만 남는다
- p값이 경계 근처면 표본을 늘려 재검정 — 산포 문제는 방치 비용이 크다
함께 읽으면 좋은 글
“통계량과 분포만 바뀐다”는 프레임의 뼈대를 이루는 개념을 한 번 더 다지고 싶다면 이 글이 좋다.